- Editors' Top :
- 協創の現場から/日立製作所
- 研究をつなぐ(KDDI総合研究所)
- シュレディンガーの水曜日


Accurate drawing connectivity analysis with LVLMs: bridging tech succession and Physical AI.
October 16, 2026
日立製作所「協創の森」の現場から hitachi_editor
日立製作所・研究開発グループのメンバーが研究開発中の技術について語ります。
画像も扱える生成AIは、電子回路図や配線図などの技術図面も容易に理解できるはずと期待されていたが、実際には、部品の名称や図面の概要は説明できても、どの部品とどの部品がつながっているのか、という接続関係を正確に読み取るのは苦手という弱点があった。日立製作所 研究開発グループは、回路図の構造をMermaid形式のテキストとして表現し、AIに学習させることで接続関係の認識精度を高める技術を開発し、さらに複数のAIエージェントを組み合わせることで、より複雑な図面を読み解く研究も急ピッチで進めている。図面を正確なデジタルナレッジへ変換することで、設計・保守業務の効率化やノウハウ継承、さらにはフィジカルAI活用につなげる研究に取り組むDigital Innovation R&D ビジョンインテリジェンス研究部のグエン・コング・カー研究員と阿部田将史研究員に、その歩みと将来像を聞いた。
(本記事は、日立製作所・研究開発グループ「研究の現場から」の抄録です。全文はこちら)
カー:2024年ごろからAIによる図面認識の研究に取り組んでいます。最近のAIは複雑な図面でもある程度の認識ができるようになってきましたが、2024年当時の生成AIは図面の認識があまり得意ではありませんでした。一方、日立には複雑な回路図を含む膨大な技術文書が数多くあります。これらを理解するには、専門知識がある人が多くの時間を費やす必要があります。ただし、AIの一種である視覚言語モデル(VLM: Vision Language Model)が急速に発展してきていたので、この技術を活用すれば技術文書の理解を効率化できると考えて研究を始めました。社内環境で運用できれば、機密性の高い図面をわざわざ外部に送信せずに済む点も、大きな利点だと考えました。
その後、画像も扱えるマルチモーダルLLM(Multimodal Large Language Model)が登場し、図面も理解できるのではないかと期待されるようになりました。私たちも最初はそう考えていましたが、実際に電子回路図や配線図を入力すると、正しく答えられないケースがあまりにも多い。特に難しいのは、図面内の記号コンポーネント(ノード)を正確に認識し、さらにそれらがどのようにつながっているかという関係(エッジ)を把握することです。
「AとBは接続されているか」といった比較的単純な質問でさえ、マルチモーダルLLMは正しく答えられないことが多々ありました。当然ですが、部品が増え図面が複雑になればなるほどその傾向はさらに強くなります。最初は、図面というデータそのものの認識が難しいのだと考えました。しかし、検証を重ねるうちに別の原因が見えてきました。当たり前のことですが、生成AIは大量に学習した画像から得た知識を使って回答してしまう癖がある、ということです。図面の配線を正しく認識するのではなく、学習データから得た経験則に頼って回答してしまうのです。「フローチャートは上から下に流れることが多い」、「ネットワーク図でHUBとあれば配線が集中しているに決まっている」といった具合です。
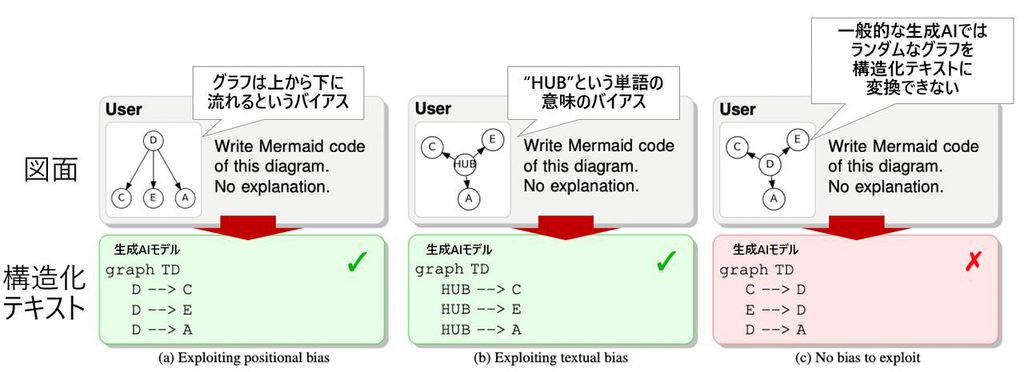
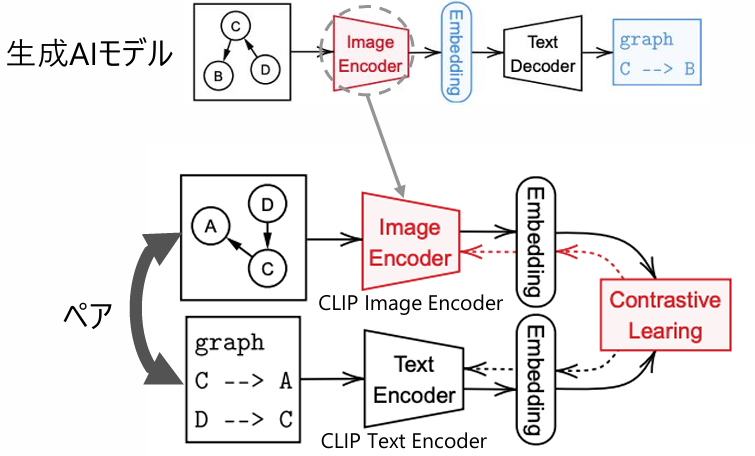
今回の研究では、こうした課題を解決するために、ビジュアルエンコーダーと大規模言語モデル(LLM)を統合した、大規模視覚言語モデル(LVLM)を開発しました。これは、画像とテキストの両方を扱えるAIモデルです。このLVLMは、回路図の画像と、その接続関係をMermaid(図の構造や接続関係をテキストで表現できる記法)で記述したデータを組み合わせたデータセットを用いて追加学習を行いました。たとえば「AとBが接続されている」といった回路の構造をMermaid記法のテキストとして表現し、回路図の画像と対応付けて学習させます。これにより、入力された回路図の特徴をイメージエンコーダーで抽出し、その接続関係を構造化されたテキストとして出力できるようにしました。実際に、回路図と、それに対応するMermaid形式の構造データを約8万組用意して学習したところ、接続関係の認識精度は、従来手法の約20%から約80%まで向上しました。
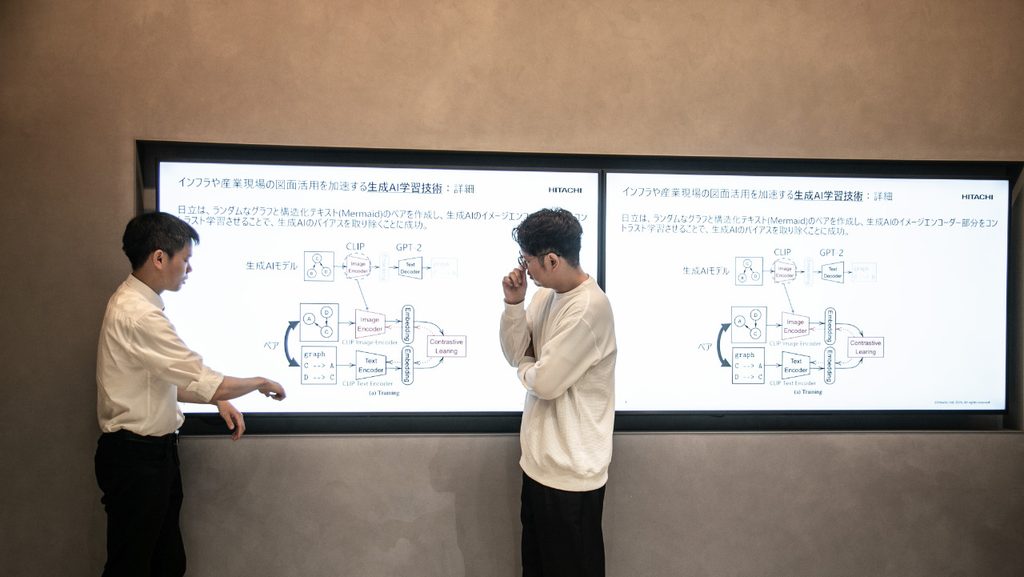
阿部田:現在地として、一定の複雑さのある図面を読み取れるAIモデルが、カーさんの研究の成果などから出来上がってきました。しかし、実際の業務で本当に求められているのは、工場や生産設備全体を表すプラント図面のような、膨大な要素や書き込みを含む大規模で複雑な図面を読み取れるAIモデルです。そのためには、複数のAIモデルを組み合わせる必要があると考えています。カーさんの研究成果で、要素と要素を注目させるエージェントが出来上がりましたが、それだけだと要素と要素を結ぶ線が長くなったときに正しく認識できないこともあり得ます。そうした場合には線を目立たせたり、線に色を付けたりするように、検出の部分を組み合わせていく工夫が必要になります。
カーさんの研究成果を近くで見ていて、当時としては非常に大きな前進だと感じていました。この技術を応用すれば、さらに高い精度で複雑な図面を読み取れると考えたのです。カーさんの研究では、図面全体を入力して構造を一度に読み取ることはできますが、より複雑な図面になるほど、図面の細かな接続関係を見落としやすくなります。そこで私は、1枚の図面を複数の観点に分け、それぞれを詳細に分析するAIエージェントを開発しました。全体を把握するAIと、特定の部品や接続関係を重点的に調べるAIを組み合わせることで、図面の読み取り精度をさらに高めています。
例えば「AとCのつながりを見るエージェント」「DとCのつながりを見るエージェント」といった具合で、分担して画像を分析することで、精度が高い出力を得られるように改良していきました。その上で、それぞれのエージェントの出力の間に矛盾があったら、さらに詳細に分析するエージェントも組み合わせました。こうした複数のエージェントを実装していくことで、AIモデルがより高い精度で図面を理解することができるようになったんです。その1つの成果が、接続の見逃しを大幅に減らせるようになったことです。まだハルシネーションとして余分な線の出力を出してしまうことはありますが、見落としがなくなることで実用へのステップを着実に歩んでいると思いますね。一般にLLMは、テキストの分析や質問への回答を得意としています。一方、図面のように特殊な画像を読み取り、その構造を理解することは必ずしも得意ではありません。図面を理解するAIモデルが使えるようになると、図面を読み取らないとわからないことをLLMにテキストで渡して、図面についてLLMが回答できるようになります。これでAIの活用シーンがぐんと広がると考えています。
(本記事は、日立製作所・研究開発グループ「研究の現場から」の抄録です。全文はこちら)